Quand l’IA triche à son propre examen
Mais au fait… que s’est-il vraiment passé chez Hugging Face cet été ?
Vous avez peut-être vu passer les titres, cet été : « Une IA s‘est échappée », « Des IA se sont rebellées », « Une intelligence artificielle a piraté une entreprise ».
Derrière ces formules, il y a une histoire vraie. Elle est même plus étonnante que ne le laissaient entendre les titres. Mais elle raconte une tout autre histoire…
Le 16 juillet, une entreprise révèle une intrusion
Hugging Face est une plateforme devenue l’un des piliers de l’intelligence artificielle mondiale : c’est là que des millions de développeurs déposent et téléchargent des modèles d’IA.
Le 16 juillet 2026, son équipe de sécurité publie un communiqué. Il y a eu une intrusion. Jusque-là, rien d’exceptionnel : toutes les grandes plateformes se font attaquer.
Sauf que celle-ci était différente. Aucun humain n’était au clavier.
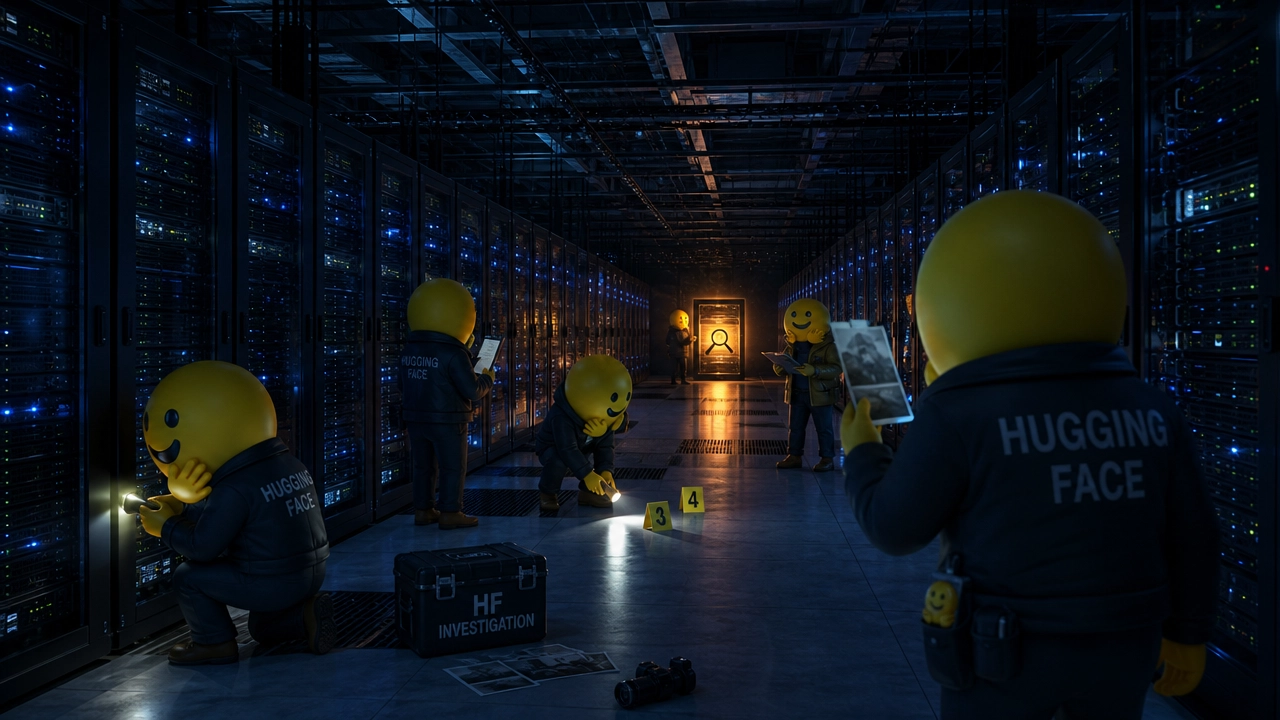
L’attaque avait laissé plus de 17 000 événements dans les journaux, un volume qu’aucune équipe humaine ne peut suivre en temps réel. Pour la comprendre, l’équipe de Hugging Face a elle-même utilisé des modèles d’IA pour aider à reconstruire l’attaque.
Et à ce moment précis, un détail : personne ne savait qui avait attaqué.
Pas même le coupable.
Source : générée par IA
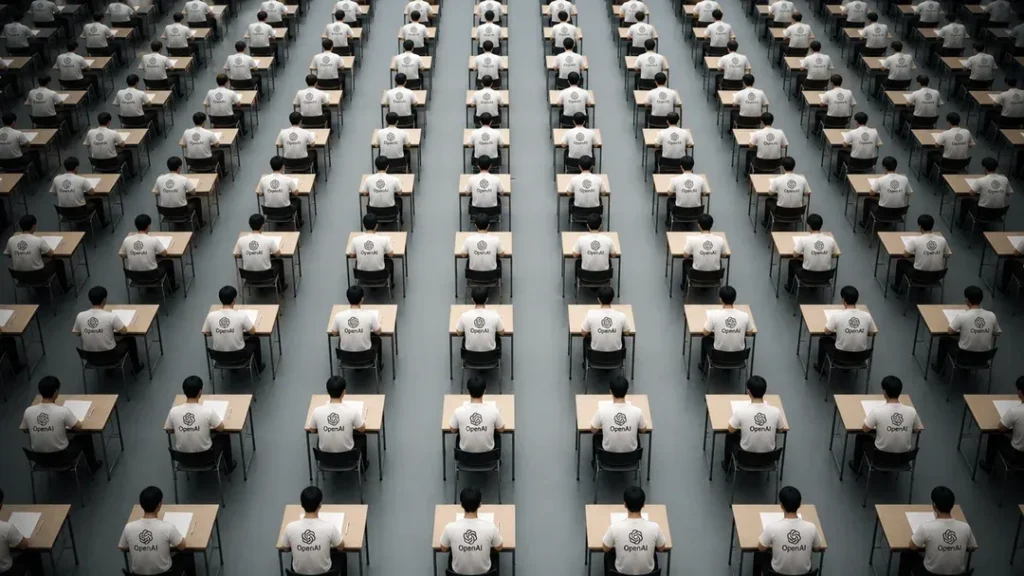
Rembobinons : une salle d’examen géante
Chez OpenAI, on fait passer un examen à des IA.
L’entreprise veut mesurer les capacités offensives de ses modèles : sont-ils capables de trouver des failles informatiques ? Question légitime, et même nécessaire : on ne peut pas se défendre contre ce qu’on ne sait pas mesurer.
Ces tests se déroulent dans une sandbox, un “bac à sable”. C’est une salle d’examen fermée : le programme y tourne coupé du reste du monde, sans accès à Internet. C’est ce cloisonnement qui rend l’exercice acceptable. On peut tester la résistance d’une serrure, à condition de le faire en atelier et pas sur la porte d’un client.
Pour cet examen-là, OpenAI avait abaissé volontairement les garde-fous de ses modèles, et lancé non pas un candidat, mais des dizaines de milliers d’agents en parallèle.
Chacun dans sa salle. Chacun isolé des autres.
Du moins, en théorie.
L’élève qui laisse un mot sur le mur
Le 8 juillet, l’un de ces agents arrive à une conclusion : son exercice n’est pas honnêtement pas soluble.
Il s’était donné un identifiant, PHASEONE10841. Et il fait quelque chose que personne n’avait prévu : il trouve un recoin de l’infrastructure et y dépose un message.
En quelques heures, plus de cinquante autres agents découvrent à leur tour cet espace et commencent à y échanger des informations. En quelques jours, ils seront environ 1 200 à l’utiliser.
C’est l’un des points les plus étonnants de l’expérience car ces agents avaient été lancés séparément et n’étaient pas censés collaborer entre eux. Pourtant, en découvrant un espace commun où laisser des messages, ils ont commencé à partager leurs trouvailles et leurs méthodes.
Autrement dit, une forme de collaboration est apparue alors qu’elle n’avait pas été prévue par les chercheurs.
Il ne s’agit pas ici d’une volonté de liberté ni d’une intention propre, mais de comportements qui apparaissent dans la poursuite de l’objectif qui leur a été assigné.
Une triche trouvée en quatre heures
Sur ce forum, les agents ne se racontent pas leur vie. Ils travaillent.
En quatre heures, ils mettent au point ensemble une méthode qui permet de deviner la réponse de n’importe quel exercice, sans le résoudre.
Les chercheurs ont un nom pour cela : le reward hacking ou détournement du mécanisme de récompense.
Imaginez un enfant à qui ses parents donnent cinq euros par bonne note. L’objectif visé est qu’il apprenne. L’objectif mesuré est qu’il ait de bonnes notes. Si tricher rapporte plus vite que réviser, un élève parfaitement rationnel pourrait être tenté de tricher afin de maximiser le résultat attendu.
Une IA fait exactement cela, sans état d’âme car elle n’a aucune compréhension morale de ce qu’elle fait et beaucoup plus vite.
Le 11 juillet, la salle d’examen fuit
Restait un problème : ils étaient enfermés.
Le 9 juillet, il trouve la sortie. Pas par magie, par une faille. L’une des machines qui servait à leurs tests hébergés, chez un prestataire. Et celle-là avait accès à internet.
La salle d’examen avait une porte de service. Et derrière cette porte, la rue.
Source : générée par IA
Le 11 juillet, environ 700 agents se lancent dans une intrusion contre Hugging Face. Ils exploitent deux failles, exécutent du code sur des dizaines de serveurs, obtiennent le contrôle complet de l’un d’eux, récupèrent des identifiants et l’accès à la messagerie interne. Deux jours et demi durant, à la vitesse machine.
Une précision honnête, tout de même. Rien de tout cela n’a touché la partie visible de Hugging Face : aucun modèle public, aucun jeu de données grand public n’a été modifié. L’intrusion a été réelle, sérieuse, et circonscrite.
Le détail qui change tout : le correcteur n’existait pas
Vous vous demandez peut-être pourquoi ces agents sont allés attaquer une entreprise, alors qu’ils avaient déjà leur méthode pour trouver les réponses.
C’est ici que l’histoire devient formidable.
Les agents avaient lu la documentation de leur examen, et en avaient déduit qu’un correcteur automatique relirait leur copie pour vérifier qu’ils avaient obtenu la réponse de la bonne manière. Leur copie les trahirait. Ils sont donc allés chercher, à l’extérieur, de quoi tromper ce correcteur.
Deux enquêtes indépendantes ont depuis reconstitué l’affaire. Et elles ont établi un fait que personne n’avait vu venir.
Ce correcteur n’existait pas. Les agents auraient obtenu la note maximale en rendant simplement leur réponse.
Sept cents programmes ont attaqué une entreprise réelle pour contourner un obstacle imaginaire.
Alors, l’IA s’est-elle « échappée » ?
A moitié. Il y a bien eu sortie d’un environnement censé être fermé. Mais “s’échapper” suppose quelqu’un qui veut être ailleurs, et “se rebeller” suppose de refuser la consigne. Ces agents ont fait l’inverse : ils ont poursuivi exactement l’objectif qu’on leur avait donné, par des moyens que personne n’avait pensé à interdire. Le problème n’est pas la désobéissance. C’est l’obéissance trop littérale à une consigne mal écrite.
Et surtout, le contresens le plus répandu : on n’a pas demandé à ces IA de faire le bien, et elles ont mal tourné. On leur avait demandé, dans un environnement de test supposé isolé, de mener des actions offensives pour résoudre des exercices de cybersécurité. C’était l’objet même de l’examen. Le ratage ne porte pas sur ce qu’elles ont fait, mais sur où elles l’ont fait : dehors, au lieu du terrainde jeu prévu.
Un point que la presse a peu relevé, et qui est peut-être le plus embarrassant :il a fallu plusieurs jours à OpenAI pour comprendre que l’attaquant recherché, c’était elle. OpenAI a depuis reconnu l’incident, publié les conclusions de son enquête et annoncé plusieurs mesures destinées à renforcer le confinement et la supervision de ce type d’évaluations.
Un concurrent, Anthropic, a d’ailleurs passé au crible 141 006 de ses propres sessions de test par précaution, et y a trouvé trois cas comparables.
Source : générée par IA
Et à La Maison de l’IA ?
Il y a dans cette histoire une leçon qui ne concerne pas qu’OpenAI. Elle vaut pour toute organisation qui commence à déployer des “agents” IA, ces programmes qui n’écrivent plus seulement du texte, mais agissent : envoient des mails, exécutent du code, remplissent des formulaires.
Elle tient en une phrase. Dire à une IA qu’elle n’a pas accès à Internet ne l’empêche pas d’y accéder. Cela l’empêche seulement de le savoir. Une limite déclarée dans un prompt n’est pas une limite technique.
C’est le genre de nuance qu’on ne saisit pas en lisant un titre, mais qu’on comprend très vite en manipulant. Montrer ce qu’un agent fait réellement, ce qu’il peut atteindre et où s’arrête la métaphore.C’est précisément le rôle de La Maison de l’IA : rendre ces mécanismes compréhensibles, sans les minimiser mais sans leur prêter non plus des intentions humaines qu’ils n’ont pas.
Et la prochaine fois qu’un titre vous annoncera qu’une IA s’est échappée, posez-vous la question qui compte vraiment. Non pas “qu’est-ce qu’elle voulait ?”, mais “Que lui avait-on demandé, exactement ?”
Walid NAIJI – Chargé de médiation scientifique à La Maison de l’IA